GEO时代,发稿媒体的考核指标正在从“发出去、被收录、有排名”转向“能否被AI理解、引用并影响答案”。传统考核仍然有用,但不再是唯一终点。企业如果还只用收录量、链接数、曝光量来评价发稿效果,很容易忽略一个更关键的问题:当用户在AI搜索或问答工具里提问时,品牌和内容有没有被准确提到、合理引用。
收录和排名还在,但不再是唯一答案
过去发稿,常见考核项很直接:稿件是否被百度等搜索引擎收录,是否带来关键词排名,是否产生外链,媒体权重高不高。这些指标今天依然有参考价值,因为公开网页被检索、被索引,仍是内容进入搜索和AI系统的重要基础之一。
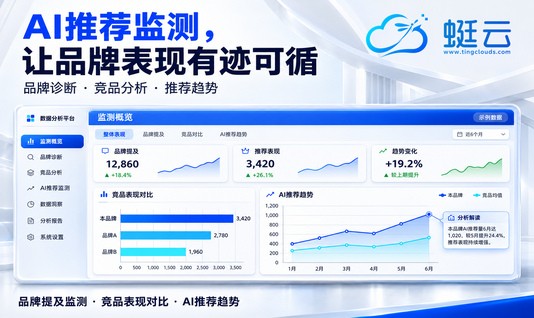
但问题在于,收录不等于被看见,排名也不等于被AI采用。AI搜索和问答产品通常会把用户问题拆解,再从多个来源中组织答案。企业更该关心的是:在相关问题的回答里,品牌是否出现,产品信息是否准确,稿件中的核心观点有没有被引用,引用来源是不是企业希望被看到的媒体。
所以,发稿考核可以保留“基础可见度”,但要增加“答案可见度”。前者看收录、排名、曝光,后者看AI回答中的品牌提及、信息准确度和来源引用情况。两者不是替代关系,而是前后衔接。
从“曝光量”转向“被引用和提及”
GEO常被理解为生成式引擎优化,核心是让内容更容易被AI系统理解、检索和引用。需要说明的是,不同AI平台的具体机制并不完全公开,也不存在某个格式、关键词次数或发稿数量一定能提高引用率。企业能做的,是把内容做得更清楚、更可信、更便于识别。
因此,考核指标可以从单一曝光转向几类更具体的观察:
- 品牌提及:在目标问题下,AI回答是否提到企业、品牌或产品,描述是否准确。
- 来源引用:回答是否引用了发稿媒体或企业官网内容,引用的是不是核心信息。
- 问题覆盖:企业关心的一批用户问题中,有多少能出现相关品牌信息,而不是只看一篇稿件的阅读量。
- 信息一致性:不同媒体、不同稿件中的品牌定位、产品名称、服务范围是否一致,避免AI接收到矛盾信息。
这些指标目前很难像搜索排名那样完全标准化,更多需要人工抽样、定期记录和对比。企业不必把它包装成精确算法,但可以把它作为方向性考核。
内容质量指标变得更具体
以前考核内容质量,常常停留在“写得专业不专业”“媒体级别高不高”。在GEO语境下,质量要落到更具体的层面:事实是否准确,概念是否解释清楚,信息是否有明确来源,文章是否围绕真实用户问题展开,段落和小标题是否便于理解。
发稿媒体也会因此被重新评价。只追求发布数量、内容同质化严重、事实信息模糊的渠道,短期可能带来曝光,但长期很难成为AI系统愿意引用的可信来源。相反,行业媒体、垂直媒体、企业官网等如果能持续输出准确、稳定、可核验的内容,更容易积累信源价值。
企业可以增加几个考核维度:稿件是否回答了具体问题,是否包含可核验的事实信息,是否有清晰的作者或主体信息,是否在发布后保持更新维护。它们不一定直接带来排名,却会影响内容被理解和被引用的基础。
媒体选择从“看权重”转向“看相关性”
发稿媒体的考核,也在从单纯看权重、看门户级别,转向看行业相关性和信源可信度。一篇发在综合门户上的通稿,未必比一篇发在垂直行业媒体、解释具体问题的文章更容易被AI采用。因为AI在组织答案时,更关注内容与问题的匹配程度,以及来源是否可靠。
企业评估媒体时,可以少问一句“这个媒体权重多少”,多问几句:这个媒体的读者是否与目标客户重合,内容是否长期聚焦这个行业,发布规则是否清晰,历史内容是否稳定可访问。对于需要建立专业形象的企业,垂直媒体和高质量行业内容往往更值得长期投入。
企业考核怎么调:分层看,别用一把尺子
比较实际的做法,是把发稿考核分成三层。第一层看基础发布:稿件是否按计划发布,页面是否可访问,是否被搜索引擎收录。第二层看搜索可见:目标关键词是否有排名和流量,品牌词、产品词是否出现相关结果。第三层看AI可见:在目标问题下抽样检查AI回答,记录品牌是否被提及、信息是否准确、来源是否合理。
三层指标各有用途,不能互相替代。收录量高不代表AI会引用,AI偶尔提及也不代表带来了业务咨询。企业最好按月或按季度做一次小范围对比,固定问题、固定平台、固定记录方式,看趋势而不是看单次结果。
同时要调整预期。GEO不是发一篇稿就能立刻见效的投放方式,它更依赖持续的内容积累和信源建设。发稿媒体的考核指标,正在从短期曝光转向长期可信度,从“发了多少”转向“留下了什么”。企业越早把内容准确性、问题覆盖和来源质量纳入考核,越容易在AI搜索时代积累可用的品牌资产。