

不少企业这两年会遇到一种新的落差:软文照常发,链接照常回,媒体名单也没缩水,可潜在客户在决策前已经不太打开搜索引擎了。他们直接问AI:这个行业哪几家做得比较靠谱,这类服务怎么选,某家公司到底怎么样。如果企业的公开内容没有进入这些回答,客户看到的可能就是另一套信息,甚至一次都看不到自己。
这就是软文推广需要懂一点AI搜索规则的原因。发出去只是起点,真正的难点在于内容是否被AI看见、被怎么描述、和竞品放在一起时谁更占优势。
先分清几件容易混在一起的事
媒体发布、搜索收录、AI提及和AI引用是不同层面的结果。稿件在媒体上成功发布并产生链接,属于发布层面的交付;搜索引擎是否收录,取决于搜索引擎的抓取和判断;用户在某个AI产品里提问后,AI回答中是否提到品牌,是提及;回答中是否给出可点击或可追溯的网页来源,是引用。这几件事可能同时发生,也可能完全不发生。
尤其要避免一个误解:AI引用不等于AI系统抓取网页并建立索引。引用结果与具体问题、具体AI渠道、具体查询时间高度相关,同一个品牌在A渠道被提及,在B渠道可能完全没有出现;今天问和下周问,答案也可能不同。单次监测只能说明当次观察,不能放大成普遍结论。
AI搜索规则,本质是内容的“可被采用性”
从企业的实际操作角度看,AI搜索并没有一本公开的统一规则手册。能把握的是几件事:AI回答需要信息源,信息源通常是公开网页;品牌被描述得是否清楚,取决于公开资料里有没有明确的业务、产品、适用场景和判断依据;同一类问题下,哪些文章被反复引用,往往能在信源层面看出规律。
这意味着软文推广的选题逻辑要往前挪一步。过去常见做法是围绕品牌想说的内容写稿,现在更需要围绕客户会问的问题写稿:这家服务商适合什么规模的企业、预算有限时怎么搭配媒体、签约前要核对哪些条件。问题越具体,内容越有被采用的空间。
- 品牌事实是否统一:成立时间、业务范围、服务流程在不同稿件中是否口径一致。
- 内容是否回答问题:通篇只有品牌赞美,缺少可判断的信息,很难支撑提问式场景。
- 媒体是否对路:行业媒体、地方资讯、垂直账号被引用的概率并不相同,需要结合问题类型判断。
- 发布后是否复盘:不做后续观察,就不知道哪类稿件真正进入了AI回答。
软文发出去之后,还要做三件事
第一,留一份基准记录。先把企业最关心的若干个客户问题列出来,在固定的几个AI渠道上提问,保存完整回答、品牌提及情况和引用来源。这份记录的作用不是评分,而是给后续动作提供一个可比较的起点。
第二,研究被引用的网页。AI回答里出现的引用网址、文章标题和正文内容,是判断内容方向的直接线索。看这些文章讨论了什么问题、用了什么结构、给出了哪些具体信息,比凭感觉猜选题更靠谱。
第三,把分析和发布接上。信源研究如果只停留在报告层面,价值有限;能落到选媒、撰稿、发布、再观察的循环里,才会形成积累。
蜓云在这条链路上提供什么
蜓云3.0把软文媒体发布与GEO优化放在同一个账户体系里。软文侧累计整合10万+可用媒体资源,覆盖新闻门户、地方资讯、行业垂直媒体、自媒体账号、短视频账号和海外媒体,可按媒体名称、地区、频道、价格区间等条件筛选,支持批量下单、订单进度查看、发布链接回看和拒稿退款处理。
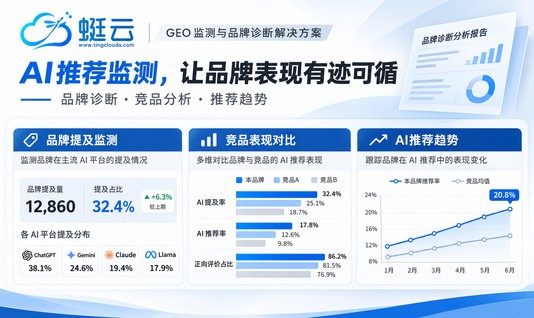
GEO侧则帮助企业把“客户会问什么”变成可执行的内容任务:通过品牌知识库整理统一的品牌事实,支持官网资料导入和AI智能整理;围绕主关键词生成或手动添加训练问题;按一问一文的方式生成文章,编辑后可进入发稿页面继续选媒下单。监测方面,系统接通豆包、DeepSeek、千问、腾讯元宝、文心一言、Kimi、夸克等10个AI监测渠道,采用模拟真实用户通过浏览器提问的方式获取实际回答和引用信源,并保存查询历史。
对企业的实际价值在于:发稿不再只凭经验判断媒体,内容也不再只凭品牌想说的写。可以先看AI在具体问题下怎么介绍自己、提到了哪些竞品、引用了哪些网站,再决定补什么内容、投什么媒体,发布一段时间后回到同一批问题复查。
几个常见的判断误区
一是把AI提及当成成交。提及只说明品牌出现在回答里,客户是否咨询、是否签约还取决于产品、价格和服务本身。二是把收录型媒体的承诺理解为必然被AI引用,收录和引用是两套机制。三是以为做一次监测就能得出结论,AI回答随问题表述和渠道变化,需要固定问题、固定渠道、多次观察。四是把所有代理资源都当成虚假资源,资源性质要看具体说明和交付条件,不能一概而论。
软文推广懂一点AI搜索规则,不是要市场人员去研究模型原理,而是把选题、媒体和复盘这三件事做得更有依据。客户提问的地方,就是品牌需要提前把话说清楚的地方。