

发了300篇软文之后,很多企业会面临一个尴尬的问题:稿子发出去了,链接也拿到了,但除了发布记录里的那一串网址,似乎没有留下什么。问题往往不在数量上,而在于从一开始就没有判断“什么样的内容才算有效”。
结合企业软文投放中反复出现的场景,可以把内容有效性拆成6个可观察的标准。这些标准不依赖单次投放的运气,而是帮助企业把每一篇稿子都变成可积累的资产。
标准一:内容有没有回答一个具体问题
无效软文最常见的写法,是从公司简介、发展历程、领导寄语开始,通篇都在讲“我们很好”,却没有回答客户真正关心的问题。有效的稿件通常能对应一个明确的问题场景,比如产品适用于什么情况、服务流程怎么走、采购时要注意哪些条件。
在实际操作中,可以先围绕品牌主关键词和业务定位整理一批潜在客户可能提出的问题,再决定写什么。蜓云的GEO系统中,用户可借助品牌知识库和问题训练能力,围绕产品用途、行业方案、品牌选择等方向整理问题,让内容写作有明确的回应对象,而不是从自我表达出发。
标准二:事实信息是否清楚、可核对
软文一旦涉及企业介绍,读者和AI都会关注里面的信息是否具体。成立时间、服务范围、产品能做什么、交付条件是什么,这些内容如果模糊或者前后矛盾,文章就很难建立信任。
有效的做法是先把品牌信息整理成统一的资料,再围绕不同问题从不同角度引用。蜓云支持将官网资料提取后由AI智能整理为知识条目,区分新增知识、更新内容和待确认冲突,企业逐项确认后再用于文章生产。这样做的实际好处是,多篇稿件在介绍同一项业务时不会出现口径不一致。
标准三:标题和正文是否兑现同一承诺
不少软文在标题里承诺了一个具体问题,正文却转向泛泛的品牌宣传。读者点开后发现内容与标题不符,会很快离开;搜索引擎和AI系统在理解内容时,也会因为主题分散而难以判断文章真正讲的是什么。
判断方法很直接:把标题当作一个问题,看正文前几段有没有给出明确回应,再看后面的段落是否都在服务这个主题。清单式标题就应该逐条回应,比较类标题就应该使用统一维度,而不是每段换一个话题。
标准四:内容是否被放在合适的媒体位置
同一篇稿件发在不同媒体上,效果可能差别很大。行业垂直媒体的读者更关注专业细节,地方资讯网站更关注区域信息,自媒体账号的读者则更在意可读性。如果只按价格选择媒体,或者长期只发同一类渠道,内容再完整也难以触达对应人群。
蜓云在媒体发布环节提供按媒体名称、地区、频道、媒体类别、新闻源属性等条件筛选资源的方式,并可收藏常用媒体、导出候选名单。企业可以先明确这篇内容要影响哪类读者,再选择匹配的媒体类型,而不是把所有稿件平均分配到同一个媒体清单里。
标准五:发布后是否留下可复用的内容资产
有效的内容不只是发布一次就结束。企业后续做品牌介绍、参加行业沟通、准备投标资料时,能否直接引用已发布稿件中的表述,是判断内容价值的另一个角度。
这要求文章在写作时就考虑长期使用,比如把服务流程、常见顾虑、产品差异点写清楚,而不是堆砌活动口号。通过草稿箱和稿件复用功能,企业可以把已经验证过的内容保存下来,在下一轮传播中调整后继续使用,减少每次从零开始写稿的成本。
标准六:有没有可观察的反馈和复盘依据
软文的效果不应该只用“有没有出链接”来判断。发布是否成功、是否被拒稿、读者在AI回答中能否看到品牌相关信息,这些都是可以记录的观察点。需要区分的是,媒体发布、搜索收录、AI提及、品牌曝光和实际成交是不同概念,不能简单画等号。
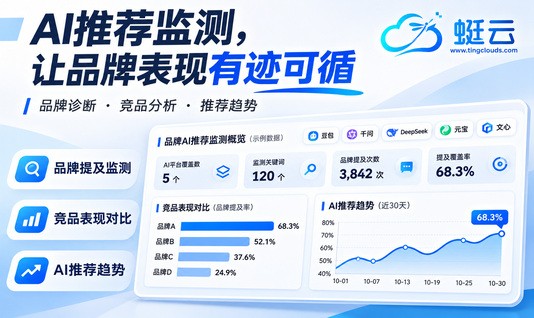
蜓云GEO系统支持对选定问题进行单次或批量监测,记录不同AI渠道在具体问题下的回答、品牌提及和引用来源。企业可以在内容发布一段时间后,用同一批问题再次查询,比较前后变化。由于结果与问题、AI渠道和查询时间有关,单次监测不宜直接当成普遍结论,更适合作为下一轮内容调整的参考。
把6个标准串成一条工作链
这6个标准并不是孤立的检查项,而是对应内容从准备到复盘的基本顺序:先确定回应什么问题,再核对事实资料,保证标题与正文一致,选择匹配的媒体,保留可复用内容,最后用可观察的记录做复盘。
对于缺少专职内容团队的企业,可以先从整理品牌资料和梳理客户问题开始;对于已有市场团队的企业,则可以把媒体筛选、批量发布和监测记录纳入常规流程。蜓云将软文媒体发布与GEO优化放在同一账户体系下,企业既能把内容发布到新闻媒体、自媒体、短视频或海外媒体,也能观察品牌在AI回答中的实际表现,让每一篇稿件都为下一轮内容判断提供依据,而不是只留下一个发布链接。